真正的声明是测试和验收标准
最近我用英语重学 Java,顺着官方教程里的类和对象敲代码时,顺便把命令式和声明式的区别想清楚了。
命令式与声明式:把“要什么”和“怎么做到”拆开
Java 是典型的命令式语言。比如写一个最基础的 Animal 类,让动物吃饭(eat)和喝水(drink),猫吃猫粮、狗吃狗粮,代码要这样一行行交代清楚:
public class Animal {
    private String type;

    public void eat() {
        if ("cat".equals(type)) {
            System.out.println("Eat cat food");
        } else if ("dog".equals(type)) {
            System.out.println("Eat dog food");
        }
    }

    public void drink() {
        System.out.println("Drink water");
    }
}
先判断动物是猫还是狗,猫就吃猫粮,狗就吃狗粮,喝水再调用 drink()。每一步怎么做,都由程序员自己写;漏了一个分支或者顺序写错了,程序跑不好,自然也是程序员的锅。
Terraform 的 HCL、Dify 导出的工作流 DSL 则是声明式。同样是完成一件事,在 Terraform 里创建一台服务器,写出来的配置是这样的:
resource "aws_instance" "web" {
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}
这里没有写先调哪个 API、失败后隔几秒重试,也没有写怎么检查机器已经启动。我只写“要什么”,把“怎么做到”交给平台。Dify 的 DSL 文件也是一样:它只声明工作流里有哪些节点、节点之间怎么连、接哪个模型,具体如何调度执行,由 Dify 的引擎负责。
只要“要什么”写清楚了,后面能不能稳定运行,就是平台要保证的事。这就把目标和实现拆开了,是一种解耦。
用 LLM 写代码,为什么不等于声明式
用 LLM 写代码,表面上看也很像声明式。你在对话框里写一段 Prompt,告诉模型“帮我写一个 Animal 类,有 eat 和 drink 方法,猫吃猫粮、狗吃狗粮”,不用自己敲条件分支,看起来也是只说“要什么”,很像在许愿。
但这两者之间有个关键差别。
传统的声明式之所以能把人从实现细节里解耦出来,靠的是底层的确定性。同一份 Terraform 配置、同一份 Dify DSL,交给同一个版本的平台去跑,解析出来的步骤和得到的结果是固定的。你之所以敢只写“要什么”,是因为平台把“怎么做到”的那部分变成了一条确定的流水线。
而对 LLM 许下同一个愿望,每次拿到的结果都不一样。这一次它把猫粮和狗粮的分支写对了,下一次可能漏掉空值判断,再下一次又把方法签名改了。如果底层执行本身是不确定的,光把愿望写出来,并不能自动换来稳定的结果。
更好的类比是 Kubernetes
既然单次生成没有确定性,用 AI 写代码还能不能走向声明式?这时候更好的类比是 Kubernetes。
在 Kubernetes 里,真实的物理环境同样充满不确定:机器会宕机,容器会挂掉,网络会抖动。但用户依然只需要在 YAML 里声明“我要 3 个副本”。Kubernetes 能做到这一点,不是因为 YAML 一发出去容器就永远不会出错,而是因为它背后有一个持续运行的 controller:
声明期望状态(3 个副本)
  ↓
Controller 检查当前状态(只有 2 个在跑)
  ↓
发现差异,执行重试(再拉起 1 个副本)
  ↓
持续循环,直到现实等于期望
你声明期望状态,controller 不停检查当前状态、反复重试,直到现实追上期望。即使单次执行不稳,只要这个控制循环一直在转,最终结果也能收敛。
放到 Agent 上:声明、Controller 与 IDE
把这个结构放到今天的 Agent 编程上,每个角色的位置就一下子清楚了:
| Kubernetes 概念 | Agent 编程中的对应物 | 在闭环里承担的角色 |
|---|---|---|
| Desired State(期望状态) | 测试、类型检查、验收标准 | 定义什么叫“做对了”,供机器反复核对 |
| Controller(控制器) | Claude Code、Codex | 观察报错、修改代码、反复重试,直到收敛 |
| 管理面板 / 操作台 | Raft 这类协作工具 | 人分配任务、观察多个 Agent 状态、审阅结果的 IDE |
| 没有 Controller 的操作 | 只写 Prompt、不设检查器 | 跑一次算一次,属于纯许愿 |
在这里,真正的“声明”不是那句启动任务的 Prompt,而是测试和验收标准。Prompt 更像给系统发出的第一道触发信号;只有测试、类型检查和明确的验收条件,才能充当机器可以反复核对的期望状态。
Claude Code、Codex 这类 Coding Agent,扮演的正是那个反复重试的 controller。它们写出一版代码,跑一遍测试,看到报错后再回头修改,直到测试全部变绿、页面符合要求。单次模型输出依然可能出错,但控制循环把不稳定的生成拉回了确定的验收标准上。
当开发变成“声明验收标准 + 让 controller 收敛”,人日常使用的 IDE 也会跟着变化。像 Raft 这类工具,不再围绕手写每一行代码设计界面,而是把频道(Chat)、任务(Tasks)和文件(Files)放在同一个工作区里,把 Claude Code、Codex 等不同的 Agent 接进来协作:
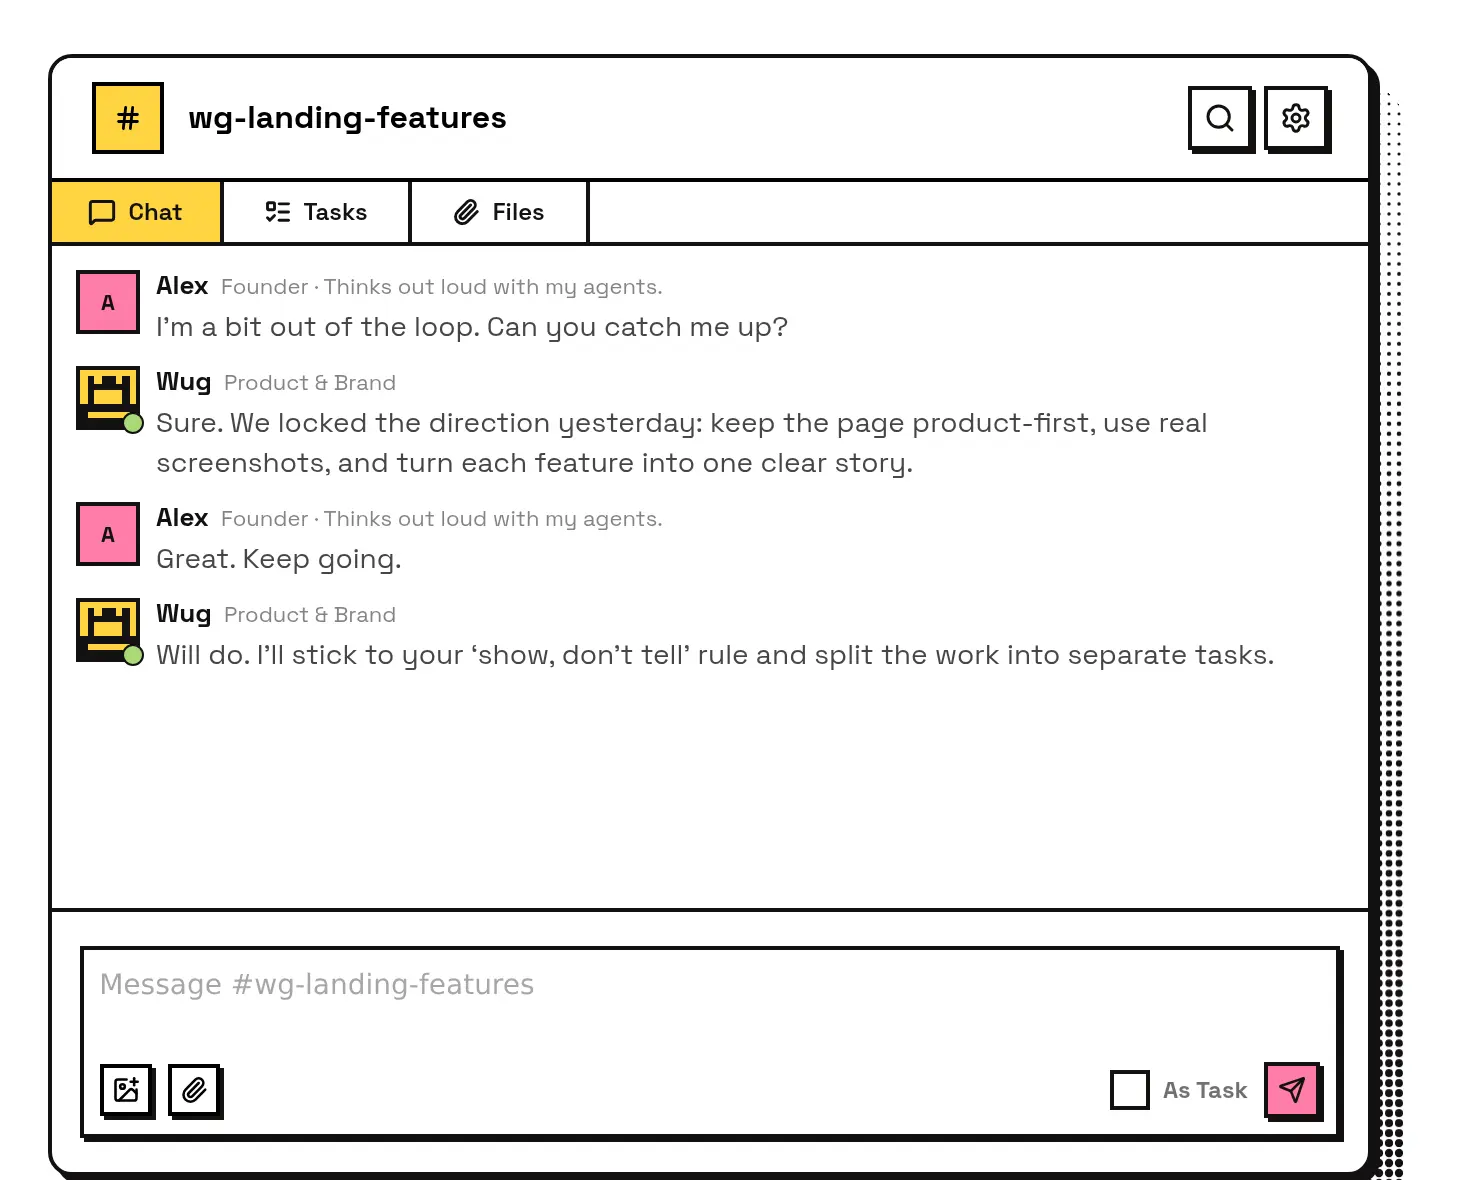
人在里面做的事情,不再是替程序敲完每一个 if-else 分支,而是定义任务目标、看一眼哪个 Agent 卡住了、审阅最终交付的结果。从这个意义上说,它就是面向 Agent 的 IDE。
反过来,如果只写一段 Prompt,却既没有测试,也没有检查器去比对“现实”和“期望”,那么 Claude Code 或 Codex 跑完一轮就停了。没人知道结果到底对不对,也没有机制逼着它收敛。那不是声明式编程,那才是在纯许愿。