本当の「宣言」はテストと検収基準である
最近、英語でJavaを学び直し、公式チュートリアルのクラスとオブジェクトに沿ってコードを書いていたとき、命令型と宣言型の違いがあらためて整理できた。
命令型と宣言型:「何がほしいか」と「どう実現するか」を切り離す
Javaは典型的な命令型言語である。たとえば最も基本的なAnimalクラスを書き、動物に食事(eat)と水飲み(drink)をさせ、猫はキャットフード、犬はドッグフードを食べるようにしたいなら、コードを一行ずつ具体的に指示しなければならない。
public class Animal {
    private String type;

    public void eat() {
        if ("cat".equals(type)) {
            System.out.println("Eat cat food");
        } else if ("dog".equals(type)) {
            System.out.println("Eat dog food");
        }
    }

    public void drink() {
        System.out.println("Drink water");
    }
}まず動物が猫か犬かを判定し、猫ならキャットフード、犬ならドッグフードを食べさせ、水を飲むときはさらにdrink()を呼び出す。一歩ずつどう進めるかは、すべてプログラマー自身が書く。分岐を一つ漏らしたり順序を間違えたりしてプログラムがうまく動かなくても、それは当然プログラマーの責任になる。
一方、TerraformのHCLや、DifyがエクスポートするワークフローDSLは宣言型である。同じく一つの作業を終えるにしても、Terraformでサーバーを一台作成する設定は次のようになる。
resource "aws_instance" "web" {
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
}
ここには、まずどのAPIを叩くか、失敗したら何秒後にリトライするかは書かれていないし、マシンが起動したことをどう確認するかも書かれていない。私は「何がほしいか」だけを書き、「どう実現するか」はプラットフォームに任せる。DifyのDSLファイルも同じだ。ワークフローにどのノードがあり、ノード同士がどうつながり、どのモデルを使うかだけを宣言し、具体的にどうスケジューリングして実行するかはDifyのエンジンが担う。
「何がほしいか」さえ明確に書かれていれば、そのあと安定して動くかどうかはプラットフォーム側が保証すべき事柄になる。こうして目標と実装を切り離すのは、一種のデカップリングである。
LLMでコードを書くことは、なぜ宣言型ではないのか
LLMでコードを書くことも、表面上は宣言型によく似ている。チャット欄にPromptを書き、モデルに「eatとdrinkメソッドを持つAnimalクラスを書いて。猫はキャットフード、犬はドッグフードを食べるようにして」と伝える。自分で条件分岐を打ち込む必要はなく、見た目には「何がほしいか」だけを伝えているようで、願い事をしている感覚に近い。
しかし、この二つのあいだには決定的な違いがある。
従来の宣言型が人を実装の細部から切り離せるのは、土台に決定性があるからだ。同じTerraform設定、同じDify DSLを同じバージョンのプラットフォームで実行すれば、解釈される手順と得られる結果は固定されている。「何がほしいか」だけを書いて済ませられるのは、プラットフォームが「どう実現するか」の部分を確定したパイプラインに変えているからである。
それに対して、LLMに同じ願い事をしても、毎回返ってくる結果は異なる。今回はキャットフードとドッグフードの分岐を正しく書けたとしても、次回はnullチェックを漏らすかもしれないし、その次はメソッドのシグネチャを変えてしまうかもしれない。土台の実行そのものが非決定的であるなら、願いを書き出すだけでは、安定した結果は自動的には手に入らない。
より適切な類比はKubernetesである
一度の生成に決定性がないとすれば、AIでコードを書くことは宣言型へ近づけないのだろうか。ここでより適切な類比になるのがKubernetesだ。
Kubernetesでも、現実の物理環境は同じように不確実性に満ちている。マシンはダウンし、コンテナは落ち、ネットワークは揺らぐ。それでもユーザーは、YAMLで「レプリカが3個ほしい」と宣言するだけでよい。Kubernetesがそれを実現できるのは、YAMLを送った瞬間にコンテナが二度と壊れなくなるからではなく、その背後で継続的に動くcontrollerがあるからだ。
期待状態を宣言(レプリカ3個)
  ↓
Controllerが現在状態を確認(稼働中は2個)
  ↓
差分を検知し再試行(レプリカを1個起動)
  ↓
現実が期待と一致するまでループを継続
ユーザーは期待状態を宣言し、controllerが現在状態を絶えず確認して再試行を繰り返し、現実を期待に追いつかせる。一度の実行が不安定でも、この制御ループが回り続ける限り、最終的な結果は収束する。
Agentに当てはめる:宣言、Controller、IDE
この構造を現在のAgentプログラミングに当てはめると、それぞれの役割の位置づけが一気に明確になる。
| Kubernetesの概念 | Agentプログラミングでの対応物 | ループ内で担う役割 |
|---|---|---|
| Desired State(期待状態) | テスト、型チェック、検収基準 | 何をもって「正しい」とするかを定義し、機械が繰り返し照合できるようにする |
| Controller(コントローラー) | Claude Code、Codex | エラーを観察し、コードを修正し、収束するまで再試行を繰り返す |
| 管理パネル / コンソール | Raftのような協働ツール | 人がタスクを割り当て、複数のAgentの状態を観察し、結果をレビューするIDE |
| Controllerのない操作 | Promptだけ書き、チェッカーを置かない | 一回動かして終わりになり、単なる願い事にとどまる |
ここで本当の「宣言」にあたるのは、タスクを起動するあの一文のPromptではなく、テストと検収基準である。Promptはシステムに送る最初のトリガー信号に近い。テスト、型チェック、明確な検収条件こそが、機械が繰り返し照合できる期待状態になる。
Claude CodeやCodexのようなCoding Agentが担っているのは、まさにその再試行を繰り返すcontrollerの役割だ。コードを書き、テストを回し、エラーを見ては戻って修正することを、テストがすべて通り、ページが要件を満たすまで続ける。モデルの一度の出力は相変わらず間違うかもしれないが、制御ループが不安定な生成を確定した検収基準へと引き戻す。
開発が「検収基準を宣言し、controllerに収束させる」ものへと変わると、人が日常的に使うIDEもそれに合わせて変わっていく。Raftのようなツールは、もはやコードを一行ずつ手書きすることを中心に画面を設計せず、チャンネル(Chat)、タスク(Tasks)、ファイル(Files)を同じワークスペースに置き、Claude CodeやCodexなど異なるAgentをつないで協働させる。
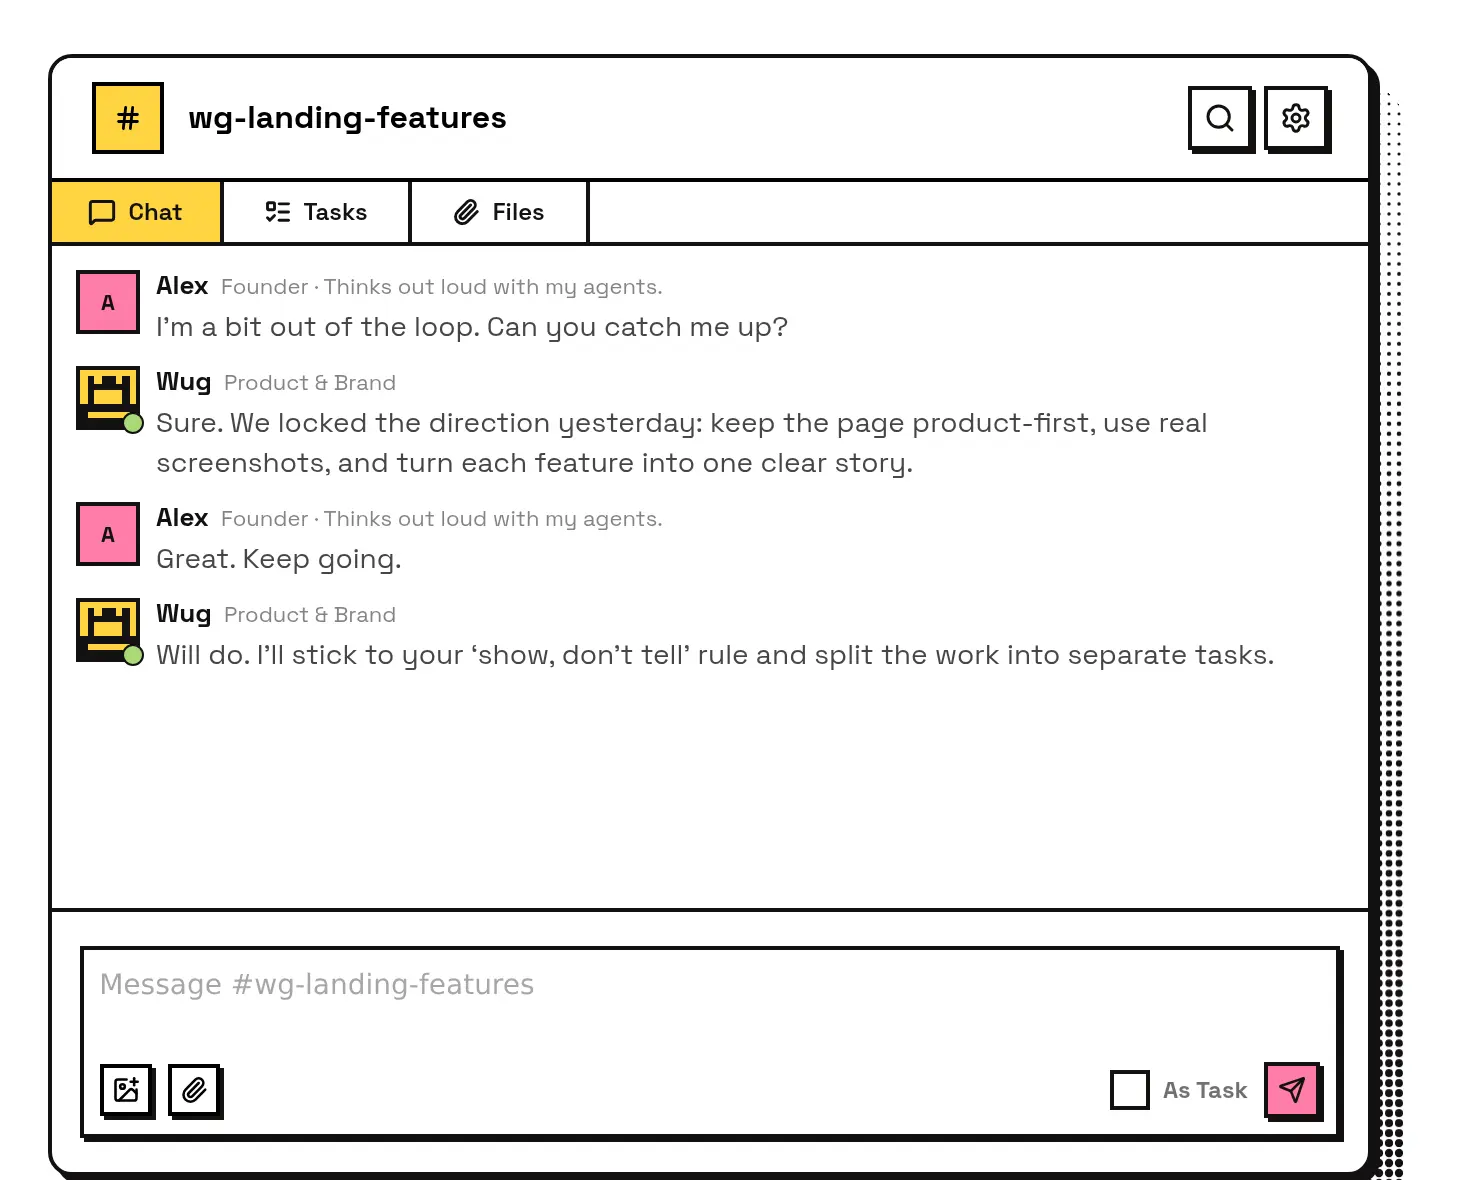
その中で人が行うのは、プログラムのためにすべてのif-else分岐を打ち込むことではない。タスクの目標を定義し、どのAgentが詰まっているかを確認し、最終的に納品された結果をレビューすることだ。この意味で、それはAgent向けのIDEだといえる。
反対に、Promptを一段落書くだけで、テストも、「現実」と「期待」を突き合わせるチェッカーも用意しなければ、Claude CodeやCodexは一通り動いたところで止まってしまう。結果が本当に正しいかは誰にもわからず、収束を強制する仕組みもない。それは宣言型プログラミングではなく、ただの願い事である。